


AIは歯科の国家試験で何点取れる?歯科医師・歯科衛生士・歯科技工士の研究結果
画像問題も含む歯科医師国家試験350問で、3つの生成AIが84%〜89%を正答しました。1 歯科衛生士や歯科技工士の試験ではどうでしょうか。実施時期・会社・モデル・対象問題が分かる具体的な成績から、歯科AIの得意・不得意が見えてきます。
目次
1. 歯科医師350問で3モデルが84%〜89%を正答
Mineらは2026年1月1〜4日、第118回歯科医師国家試験(2025年)の350問を、OpenAI・Anthropic・Googleの3モデルに解かせました。 論文の公開は2026年4月5日です。文字だけの202問と、写真・X線・図表などを含む148問を採点しています。1
| 会社・モデル | 全350問の正答率 | 文字202問 | 画像等148問 |
|---|---|---|---|
| OpenAI:GPT-5.2 Thinking(ChatGPT) | 84.3%(295問) | 91.6% | 74.3% |
| Anthropic:Claude Opus 4.5 | 84.0%(294問) | 93.6% | 71.0% |
| Google:Gemini 3 Pro Preview | 88.9%(311問) | 95.5% | 79.7% |
入力には原文の日本語と画像を使い、各問の初回回答を採点しました。検索は無効で、原則1問ごとに会話をリセットしています。GPT-5.2 ThinkingはProのHeavy、ClaudeはMaxの拡張思考、GeminiはAI StudioのHigh設定でした。1
興味深いのは、同じ研究チームが第117回(2024年)で4モデルすべての誤答とした33問も再出題した点です。GPT-5.2 ThinkingとGeminiは各17問、Claudeは8問を正答し、9問は新しい3モデルもそろって誤答しました。 総合成績が高くなった後にも、解けるようになった問題と残る難問があります。1
第117回ではOpenAI o1が81.9%
別のMineらの研究は、第117回(2024年)の353問を4モデルで比べたものです。公開は2025年3月26日で、AIへの入力日は記載されていません。2
| 会社・モデル | 全353問の正答率 | 文字204問 | 画像等149問 |
|---|---|---|---|
| OpenAI:GPT-4o | 65.7% | 80.4% | 45.6% |
| OpenAI:o1 | 81.9% | 92.2% | 67.8% |
| Anthropic:Claude 3.5 Sonnet | 71.7% | 83.3% | 55.7% |
| Google:Gemini 2.0 Flash Thinking Experimental | 66.6% | 79.9% | 48.3% |
Claudeは2024年10月22日更新版です。同じ353問ではo1が他の3モデルより高い正答率でした。前の表は第118回、こちらは第117回と、比較に使った試験も異なります。2
2. 歯科衛生士213問ではGemini 2.5 Proが85%
Kaneyasuらは第34回歯科衛生士国家試験(2025年)の213問を使い、文字だけの問題と画像等を含む問題を比較しました。 2025年6月20日オンライン公開、AIへの入力日は記載されていません。以下は同研究の4モデルの成績です。3
| 会社・モデル | 全213問の正答率 | 文字74問 | 画像等139問 |
|---|---|---|---|
| OpenAI:GPT-4.5 Preview(ChatGPT) | 76.1% | 87.8% | 69.8% |
| Google:Gemini 2.0 Flash Thinking Experimental | 75.1% | 82.4% | 71.2% |
| Google:Gemini 2.5 Pro Experimental | 85.0% | 90.5% | 82.0% |
| Anthropic:Claude 3.7 Sonnet | 77.5% | 91.9% | 69.8% |
Gemini 2.0は2025年1月21日更新版です。各問で会話をリセットし、問題文・選択肢・原画像を入力しました。Claudeは拡張思考を使用した設定です。文字問題ではClaude、画像等の問題ではGemini 2.5 Proが最も高い数値で、総合成績と問題形式別の成績では見え方が変わります。3
2023年の文字73問ではGPT-4が75.3%
Yamaguchiらは2023年11月12日、第32回(2023年)から画像を含まない73問を抽出して比較しました。論文公開は2024年2月29日です。4
| 会社・モデル/サービス | 正答数/73問 | 正答率 |
|---|---|---|
| OpenAI:GPT-3.5(2023年9月版) | 46問 | 63.0% |
| OpenAI:GPT-4(2023年9月版) | 55問 | 75.3% |
| Microsoft:Bing Chat(GPT-4ベース) | 50問 | 68.5% |
| Google:Bard(2023年9月19日版) | 48問 | 65.8% |
Bardは回答不能の1問も含めた全73問で表示しました。この研究ではモデル間の統計的な差は確認されず、評価範囲は抽出した文字問題です。後の213問の研究は画像等を含むため、試験の範囲を広げた評価として読めます。3,4
3. 歯科技工士の学説試験では文字と画像で大きな差
Fukudaらは2024年7月18日、2018〜2022年の歯科技工士国家試験の学説問題400問を、OpenAIのGPT-4oに解かせました。 2025年6月9日公開の論文です。日本語の問題文と原画像を入力し、選んだ理由と他の選択肢が不適切な理由も求めています。5
| GPT-4oに解かせた問題 | 正答数/問題数 | 正答率 |
|---|---|---|
| 全体 | 255/400問 | 63.8% |
| 文字だけ | 182/252問 | 72.2% |
| 画像・図表などを含む | 73/148問 | 49.3% |
材料・器械・加工に関する問題では53/63問、84.1%を正答した一方、矯正に関する問題では12/26問、46.2%でした。全体の平均を分けると、専門領域ごとの得意・不得意まで見えてきます。対象は学説試験で、入れ歯などを実際に製作する実地試験は含みません。5
別の240問ではo1が67.5%
Mineらは2022〜2024年の学説試験240問を比較しました。公開日は2025年3月6日、入力日は未記載です。問題文と原画像を使い、各問1回の回答を採点しています。6
| 会社・モデル | 全240問の正答率 | 文字139問 | 画像等101問 |
|---|---|---|---|
| OpenAI:GPT-4o | 58.3% | 68.3% | 44.6% |
| OpenAI:o1 | 67.5% | 79.1% | 51.5% |
| Anthropic:Claude 3.5 Sonnet | 64.6% | 71.2% | 55.4% |
Claudeは2024年10月22日更新版です。全体ではo1、画像等の問題ではClaudeが数値上は最高でしたが、画像等の3モデル間には統計的な差が確認されませんでした。最初の400問とは対象年度も問題構成も異なり、GPT-4oの63.8%と58.3%は別々の問題セットの結果を示しています。6
4. 同じ歯科医師の必修問題では新モデルの成績が上昇
Hamaguchiらは2020〜2024年の歯科医師国家試験から、全7モデルが回答できた必修の文字問題346問を共通にして比較しました。 必修問題は、歯科医師に必要な基本事項を問う区分です。各サービスの無料Web版を使い、初回回答を採点した研究で、2025年10月17日にオンライン公開されています。7
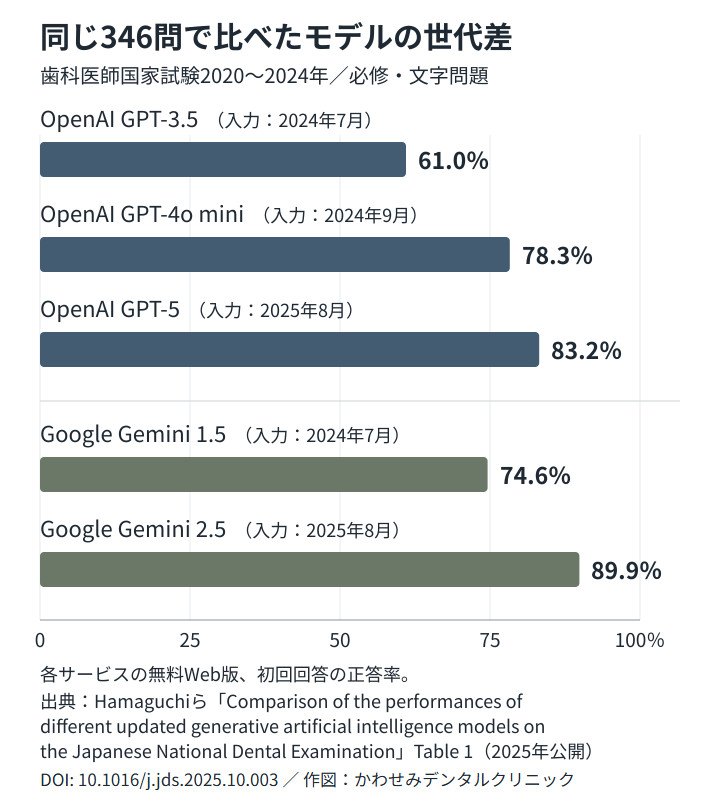
| 会社・モデル/サービス | AIへの入力時期 | 346問の正答率 |
|---|---|---|
| OpenAI:GPT-3.5 | 2024年7月 | 61.0% |
| OpenAI:GPT-4o mini | 2024年9月 | 78.3% |
| OpenAI:GPT-5 | 2025年8月 | 83.2% |
| Google:Gemini 1.5 | 2024年7月 | 74.6% |
| Google:Gemini 2.5 | 2025年8月 | 89.9% |
| Microsoft:Copilot | 2025年8月 | 89.3% |
| 提供会社の記載なし:MediSearch | 2025年8月 | 87.6% |
CopilotとMediSearchはサービス名で、内部モデルの詳細は論文にありません。OpenAIの3モデルはChatGPTで利用されています。7
同じ問題で比べると、GPT-3.5からGPT-5へ22.2ポイント、Gemini 1.5から2.5へ15.3ポイント高くなりました。 GPT-4o miniとGPT-5の差は4.9ポイントです。異なる研究の最高値を並べるよりも、同じ問題を解き直した比較の方が、どの世代で差が出たかをつかめます。7
年度ごとの結果では、Copilot・Gemini 2.5・MediSearchは5年度すべてで80%以上、GPT-5は3年度で80%以上でした。ここでの80%は、研究で選んだ必修文字問題に適用した基準です。7
5. 同じ画像でも主訴があると小児歯科の診断正答率が上昇
Akitomoらは2025年11月7〜10日、歯科医師国家試験の小児歯科25症例を使い、「主訴あり」と「主訴なし」を比較しました。 主訴とは、痛みや腫れなど患者さんが訴える困りごとです。どちらの条件にも口腔内写真とX線画像があり、各症例を3回ずつ、計75回答/条件で評価しました。論文公開は2026年2月20日です。8
| 会社・サービス/モデル | 診断の正答率:主訴あり | 診断の正答率:主訴なし |
|---|---|---|
| Microsoft:Copilot | 57.3%(43/75回答) | 33.3%(25/75回答) |
| Google:Gemini 2.5 | 61.3%(46/75回答) | 41.3%(31/75回答) |
両者とも無料Web版で、Copilotの内部モデルは記載されていません。病変の場所を当てる正答率も、主訴ありではCopilotが74.7%、Geminiが77.3%、主訴なしではそれぞれ38.7%、40.0%でした。8
ここでは画像の有無を変えたのではなく、同じ画像に添える患者情報を変えています。 文字問題と画像問題の別々の集団を比べる国試研究に対し、入力内容そのものの影響を追った実験です。AIが写真を見るときも、何を訴えている症例なのかが回答を左右しました。8
6. 歯科技工士400問の未査読報告では最大80.5%
Fukudaらが2026年10月21日に公開したプレプリントは、前述の2025年論文と同じ2018〜2022年の学説問題400問を4モデルで比較した報告です。 プレプリントは専門家の査読前の原稿です。著者は、2026年6月に有料の一般利用者向けWeb画面で実験し、API(プログラム用の接続口)は使わなかったと記載しています。9
| 会社・著者記載モデル | 全400問の正答率 | 文字252問 | 画像等148問 |
|---|---|---|---|
| OpenAI:GPT-4o | 63.8%(255問) | 72.2%(182問) | 49.3%(73問) |
| OpenAI:o3 | 70.8%(283問) | 79.8%(201問) | 55.4%(82問) |
| OpenAI:GPT-5 Thinking | 74.8%(299問) | 86.1%(217問) | 55.4%(82問) |
| Google:Gemini 3(詳細バージョン不詳) | 80.5%(322問) | 91.7%(231問) | 61.5%(91問) |
OpenAIが案内するGPT-4o/GPT-5 ThinkingのChatGPT提供終了は、著者が実験月とする2026年6月より前です。この未査読報告の両モデルについて、実際の使用時期とモデルの確認が残っています。9,10
モデルごとに同じ会話へ400問を順に入力し、検索なし・各問の初回回答で採点しています。この報告でo3とGPT-5 Thinkingを比べると、正答数の差16問はすべて文字問題にあり、画像等の問題は両者82問でした。全体の差を分解すると、どの形式で正答が増えたかが分かります。 両者の全体正答率の差は、論文の多重比較補正後には統計的に有意ではありませんでした。9
7. 医師・看護師・薬剤師の試験でも高得点を報告
歯科以外でも、同じ問題を複数モデルに解かせた研究があります。 医師・看護師・薬剤師から、結果の数え方が分かる3例を挙げます。
医師の文字254問ではGPT-4が79.9%
Takagiらは2023年3月16〜18日、第117回医師国家試験(2023年)から画像等を除いた254問を比較しました。OpenAIのGPT-3.5は50.8%、GPT-4は79.9%で、29.1ポイントの差です。必修に相当する問題ではそれぞれ55.1%と87.2%でした。著者は抽出した問題でGPT-4を合格相当と判定しました。2023年6月29日公開の研究です。11
看護師は配点を反映するとGPT-4が245/288点
Kuribaraらは2021〜2023年の看護師国家試験から画像・表などを除いて評価しました。下表は2023年の230問に対する成績です。一般問題等は1問1点、状況設定問題は1問2点で、研究対象の満点は288点でした。論文は2025年5月27日に公開されています。12
| 会社・モデル/サービス | AIへの入力時期(2024年) | 2023年問題の得点 |
|---|---|---|
| OpenAI:GPT-3.5 | 7月5〜29日 | 174/288点 |
| OpenAI:GPT-4 | 1月25日〜4月5日 | 245/288点 |
| Microsoft:Copilot | 2月2日〜3月5日 | 242/288点 |
著者の合否判定では、GPT-4とCopilotは対象の3年度すべてで合格、GPT-3.5は必修問題の基準に届かずすべて不合格でした。総得点に加えて必修の基準を見ると、「何点だったか」と「合格相当か」の関係が分かります。12
薬剤師345問ではo1が86.6%
Satoらは第107回薬剤師国家試験(2022年)の345問を比較しました。2025年9月18日公開の論文で、問題には図や化学構造も含まれます。13
| 会社・モデル | AIへの入力時期 | 正答数/345問・原報の正答率 |
|---|---|---|
| OpenAI:GPT-4 | 2023年11月 | 250問・72.4% |
| OpenAI:GPT-4o | 2024年5月 | 294問・85.2% |
| OpenAI:o1 | 2024年12月 | 299問・86.6% |
| Google:Gemini 2.0 Flash Experimental | 2024年12月 | 288問・83.4% |
| Anthropic:Claude 3.5 Sonnet(new) | 2024年11月 | 297問・86.0% |
これらは正答した問題数で、配点換算した得点とは別です。著者は表の5モデルをいずれも合格と判定しています。研究題名の「2024」は評価対象のAIに関する年で、使用した国家試験は2022年の問題でした。13
8. AIが解ける問題は増え、画像問題には課題が残る
歯科医師・歯科衛生士では画像を含む問題セットで8割台、歯科技工士では文字と画像等の問題の間に大きな差が報告されています。 同じ問題を比較した研究では新しいモデルの成績が上がり、過去に共通して間違えた難問を解き直す研究も始まりました。1,3,5,7
「何点取れたか」を読むとき、正答率は正解した問題の割合、得点は配点を反映した合計です。合格相当の判定には、研究で採用した必修や領域別の条件も関わります。歯科技工士研究の対象は学説試験で、製作技能は別の評価です。
当院の以前の記事「生成AIは日本の歯科医師国家試験を合格できるのか(2024)」は、2024年発表の研究を紹介していました。実験時期とモデル名、対象問題を併せて読み、総合成績に加えて画像問題の成績や繰り返し残る難問を追うと、歯科AIの現在地が具体的に見えてきます。
診療記録や画像をAIで活用するためのデータ設計は、当院の電子カルテの記事で詳しく扱っています。
関連記事
- AIの歯科相談はどこまで頼れる? 正確さ、共感、日本語の研究を読む
- 生成AIは日本の歯科医師国家試験を合格できるのか(2024)
- 電子カルテの導入は小規模歯科医院の負担を減らせるか。医療DXへ向けて、現在の厚生労働省の公開情報から見えてくる問題を探る
参考文献
- Mine Y, et al. Beyond exam accuracy: Tracking a persistent-failure set reveals visual dental reasoning gaps in multimodal LLMs. Journal of Dentistry. 2026;170:106675 著者公開版(ResearchGate)
- Mine Y, et al. Benchmarking multimodal large language models on the dental licensing examination: Challenges with clinical image interpretation. Journal of Dental Sciences. 2025
- Kaneyasu Y, et al. Analysis of multimodal large language models on visually-based questions in the Japanese National Examination for Dental Hygienists: A preliminary comparative study. Journal of Dental Sciences. 2026;21(1):198–205. 2025年6月20日オンライン公開
- Yamaguchi S, et al. Evaluating the efficacy of leading large language models in the Japanese national dental hygienist examination: A comparative analysis of ChatGPT, Bard, and Bing Chat. Journal of Dental Sciences. 2024;19(4):2262–2267
- Fukuda H, et al. Evaluating the Accuracy and Performance of ChatGPT-4o in Solving Japanese National Dental Technician Examination. International Dental Journal. 2025;75(4):100847
- Mine Y, et al. Analyzing the performance of multimodal large language models on visually-based questions in the Japanese National Examination for Dental Technicians. Journal of Dental Sciences. 2025
- Hamaguchi S, et al. Comparison of the performances of different updated generative artificial intelligence models on the Japanese National Dental Examination. Journal of Dental Sciences. 2026. 2025年10月17日オンライン公開
- Akitomo T, et al. Diagnostic Capabilities of Large Language Models in Paediatric Dentistry. International Dental Journal. 2026
- Fukuda H, et al. Format-Dependent Performance of Four Large Language Models on Japanese Dental Technician Examination Questions: A Matched Item-Level Analysis. Preprints.org. 2026年10月21日公開、第1版・未査読
- OpenAI. Retiring GPT-4o and other ChatGPT models. 2026
- Takagi S, et al. Performance of GPT-3.5 and GPT-4 on the Japanese Medical Licensing Examination: Comparison Study. JMIR Medical Education. 2023;9:e48002
- Kuribara T, et al. Performance evaluation of large language models for the national nursing examination in Japan. Digital Health. 2025 全文(Europe PMC)
- Sato H, Ogasawara K, Sakurai H. Performance Evaluation of 18 Generative AI Models (ChatGPT, Gemini, Claude, and Perplexity) in 2024 Japanese Pharmacist Licensing Examination: Comparative Study. JMIR Medical Education. 2025
執筆・監修 中村 瞬
かわせみデンタルクリニック 院長 / 歯学博士(歯科麻酔学)/ 日本歯科麻酔学会 認定医
医療記事を数多く執筆。TV取材多数
医学的根拠(エビデンス)に基づく、正確で分かりやすい情報を患者目線でお届けします。
かわせみデンタルクリニック|船橋の歯医者・矯正歯科
所在地:〒273-0005 千葉県船橋市本町6丁目3−20 ベルヴィル船橋本町 1階B号室
電話番号:047-409-2988
JR・東武鉄道「船橋」駅 徒歩4分
平日 9:00 ~ 13:00 14:30 ~ 18:00
土曜 9:00 ~ 13:00 14:00 ~ 17:00
(休診:日曜・月曜・祝日)

当院は、初診時にしっかりと検査を行い、歯周病・虫歯・根管治療から矯正歯科・小児矯正まで、丁寧にご説明のうえで治療を進める方針です。
治療後も再発予防に努め、安心して通える歯科医院を目指します。